
SPACESORTIUM ORBIT HACKATHON™
Architecture technique de référence et spécifications communes d’intégration
Première édition 2026 — Version 0.1
BUILD THE INFRASTRUCTURE · INTEGRATE THE FUTURE · JOIN THE MISSION
Préambule
Le SPACESORTIUM ORBIT HACKATHON™ ne constitue pas une simple compétition de programmation. Il représente une opération de construction technologique collective destinée à produire les premières briques fonctionnelles, interopérables et évolutives de l’infrastructure numérique SPACESORTIUM™.
La première édition rassemble plusieurs équipes appelées à travailler simultanément sur des domaines distincts mais interdépendants :
-
le cœur social ;
-
le jumeau numérique des Nations ;
-
l’intelligence artificielle natiométrique ;
-
l’observation et la visualisation ;
-
les services citoyens ;
-
les données, les API, la sécurité et l’infrastructure.
La réussite de cette opération ne dépend donc pas uniquement de la qualité individuelle des prototypes. Elle dépend également de la capacité des équipes à produire des composants pouvant communiquer entre eux, partager des données cohérentes, respecter des conventions communes et être progressivement intégrés dans une architecture globale.
Le présent document fixe les principes, standards, interfaces et règles techniques communs applicables aux six missions de la première édition.
Il constitue le référentiel technique de coordination du SPACESORTIUM ORBIT HACKATHON™.
TITRE I — DISPOSITIONS GÉNÉRALES
Article 1 — Objet du document
Le présent document a pour objet de définir :
-
L’architecture technique de référence de la première édition ;
-
Les principes communs de conception et de développement ;
-
Les standards d’interopérabilité entre les missions ;
-
Le modèle commun de données ;
-
Les règles de conception des API ;
-
Les mécanismes communs d’identité et d’authentification ;
-
Les exigences minimales de sécurité ;
-
Les règles de versionnement, de collaboration et d’intégration ;
-
Les environnements de développement, de test et de démonstration ;
-
Les critères de validation technique des livrables.
Article 2 — Champ d’application
Le présent document s’applique :
-
aux six équipes participantes ;
-
aux mentors et référents techniques ;
-
aux responsables de l’architecture SPACESORTIUM™ ;
-
aux membres de QUENTUMSPACE impliqués dans l’opération ;
-
aux partenaires techniques participant à l’infrastructure ;
-
à toute personne autorisée à contribuer au code, aux données, aux API ou aux environnements du projet.
Article 3 — Portée de la première édition
La première édition est consacrée à la construction des fondations fonctionnelles et techniques de SPACESORTIUM™.
Elle ne vise pas à finaliser l’ensemble des modules avancés du Système International de Natiométrie. Les modules spécialisés tels que :
-
NATIOMÈTRE ;
-
NATIOTRON ;
-
NATIOVAULT ;
-
NATIOSPECTRE ;
-
NATIOCIVIS ;
-
NATIOTECH ;
pourront être approfondis dans les éditions ultérieures.
Toutefois, l’architecture de la première édition doit être conçue de manière à permettre leur intégration future sans remise en cause fondamentale du socle technique.
Article 4 — Principe directeur
Toutes les équipes doivent respecter le principe suivant :
Construire séparément, mais concevoir ensemble.
Chaque équipe dispose d’un périmètre de mission propre, mais aucun composant ne doit être conçu comme un système isolé ou incompatible avec l’architecture globale de SPACESORTIUM™.
TITRE II — PRINCIPES DIRECTEURS DE L’ARCHITECTURE
Article 5 — Modularité
L’architecture doit être modulaire.
Chaque mission doit produire des composants pouvant être :
-
développés indépendamment ;
-
testés séparément ;
-
documentés ;
-
remplacés ou améliorés ;
-
connectés à d’autres composants ;
-
réutilisés dans plusieurs contextes.
Les dépendances inutiles entre équipes doivent être évitées.
Article 6 — Interopérabilité
Les composants doivent pouvoir communiquer au moyen de formats, protocoles et conventions communs.
L’interopérabilité concerne notamment :
-
les données ;
-
les API ;
-
l’identité des utilisateurs ;
-
les territoires ;
-
les institutions ;
-
les événements ;
-
les indicateurs ;
-
les notifications ;
-
les permissions ;
-
les journaux techniques.
Article 7 — Évolutivité
Les choix techniques doivent permettre une évolution progressive du système.
Les équipes doivent éviter :
-
les structures de données impossibles à étendre ;
-
les fonctions codées exclusivement pour une démonstration ponctuelle ;
-
les dépendances propriétaires non documentées ;
-
les architectures empêchant l’ajout de nouveaux modules ;
-
les solutions ne pouvant pas être déployées dans un environnement contrôlé.
Article 8 — Simplicité maîtrisée
La première édition doit privilégier une architecture simple, compréhensible et rapidement intégrable.
La sophistication technique ne constitue pas un objectif en soi.
Une solution simple, documentée, testable et intégrable doit être préférée à une solution complexe dont la maintenance et l’intégration seraient incertaines.
Article 9 — Séparation des responsabilités
Les composants doivent distinguer autant que possible :
-
la présentation ;
-
la logique métier ;
-
l’accès aux données ;
-
les services d’authentification ;
-
les API ;
-
les fonctions d’administration ;
-
les mécanismes de journalisation ;
-
les fonctions d’infrastructure.
Cette séparation doit permettre de faire évoluer l’interface sans réécrire l’ensemble de la logique métier.
Article 10 — Documentation systématique
Aucun composant ne peut être considéré comme achevé s’il n’est pas accompagné d’une documentation minimale.
Toute équipe doit documenter :
-
la finalité du composant ;
-
son architecture ;
-
ses dépendances ;
-
ses variables d’environnement ;
-
ses routes API ;
-
son modèle de données ;
-
ses procédures d’installation ;
-
ses procédures de test ;
-
ses limites connues ;
-
ses perspectives d’évolution.
Article 11 — Sécurité dès la conception
La sécurité ne doit pas être ajoutée après le développement.
Elle doit être prise en compte dès la conception, notamment pour :
-
l’authentification ;
-
l’autorisation ;
-
la gestion des rôles ;
-
la protection des données ;
-
la validation des entrées ;
-
la gestion des secrets ;
-
les journaux ;
-
les accès aux API ;
-
les communications entre services.
TITRE III — ARCHITECTURE GLOBALE DE RÉFÉRENCE
Article 12 — Architecture logique
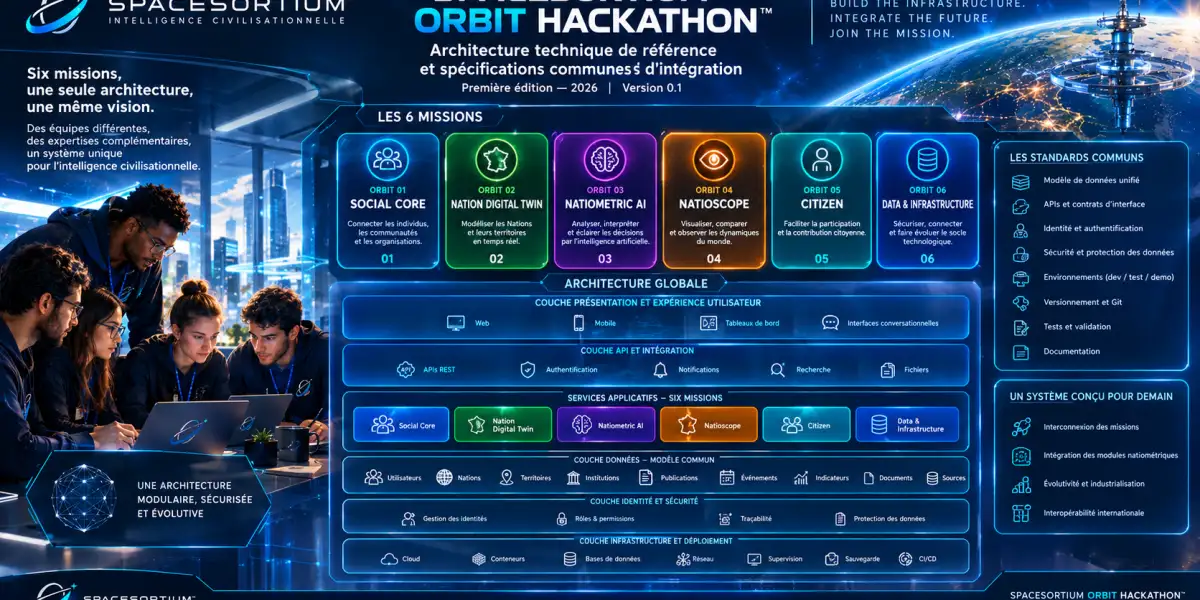
L’architecture de référence de la première édition repose sur plusieurs couches :
-
Couche présentation et expérience utilisateur ;
-
Couche services applicatifs ;
-
Couche API et intégration ;
-
Couche logique métier ;
-
Couche données ;
-
Couche identité et sécurité ;
-
Couche infrastructure et déploiement ;
-
Couche observation, journalisation et supervision.
Article 13 — Représentation fonctionnelle
L’architecture cible peut être représentée comme suit :
UTILISATEURS
Citoyens · Chercheurs · Institutions · Entreprises · Administrateurs
│
▼
COUCHE PRÉSENTATION Web · Mobile · Tableaux de bord · Interfaces conversationnelles
│
▼
COUCHE API ET SERVICES
API REST · Authentification · Notifications · Recherche · Fichiers
│
▼
COUCHE MÉTIER SPACESORTIUM
Social Core · Nation Digital Twin · Natiometric AI Natioscope · Citizen · Data & Infrastructure
│
▼
COUCHE DONNÉES
Utilisateurs · Nations · Territoires · Institutions Publications · Indicateurs · Événements · Documents · Logs
│
▼
COUCHE INFRASTRUCTURE
Serveurs · Cloud · Bases de données · Stockage Réseau · Sécurité · Sauvegarde · Supervision
Article 14 — Architecture recommandée
Pour la première édition, l’architecture recommandée est une architecture modulaire de type monolithe modulaire, éventuellement complétée par des services séparés lorsque cela est techniquement justifié.
Cette approche permet :
-
une intégration rapide ;
-
une administration simplifiée ;
-
une réduction des dépendances ;
-
une meilleure compréhension du système ;
-
une mise en production progressive ;
-
une évolution ultérieure vers des services distribués.
Le recours à une architecture entièrement microservices n’est pas obligatoire et ne doit pas être retenu uniquement pour des raisons de prestige technique.
Article 15 — Composants principaux
L’architecture globale doit prévoir les composants suivants :
-
service d’identité et d’authentification ;
-
service de gestion des utilisateurs ;
-
service de gestion des profils ;
-
service de publication et d’interaction ;
-
service de gestion des Nations et territoires ;
-
service de gestion des institutions ;
-
service d’indicateurs ;
-
service d’intelligence artificielle ;
-
service de visualisation ;
-
service citoyen ;
-
service de fichiers et documents ;
-
service de notifications ;
-
service de recherche ;
-
service de journalisation ;
-
service d’administration.
Tous ces composants ne doivent pas nécessairement être développés intégralement durant la première édition. Certains pourront être simulés ou fournis sous forme de services minimaux, à condition que leurs interfaces soient clairement définies.
TITRE IV — STACK TECHNOLOGIQUE DE RÉFÉRENCE
Article 16 — Principe de choix technologique
Les équipes peuvent proposer des technologies différentes, sous réserve de respecter les exigences suivantes :
-
compatibilité avec l’architecture globale ;
-
documentation suffisante ;
-
maintenabilité ;
-
sécurité ;
-
disponibilité des compétences ;
-
facilité de déploiement ;
-
compatibilité avec les API et formats communs.
Article 17 — Technologies recommandées
À titre de référence, la stack suivante est recommandée :
17.1 — Frontend web
-
React, Next.js ou technologie équivalente ;
-
TypeScript recommandé ;
-
composants réutilisables ;
-
gestion claire de l’état ;
-
interface responsive ;
-
accessibilité minimale.
17.2 — Backend
-
Node.js avec NestJS, Express ou équivalent ;
-
Python avec FastAPI, Django ou équivalent ;
-
autre technologie validée par le comité technique.
17.3 — Base de données
-
PostgreSQL comme base relationnelle de référence ;
-
Redis pour les besoins éventuels de cache ou de file d’attente ;
-
solution géospatiale compatible, telle que PostGIS, lorsque nécessaire.
17.4 — Stockage documentaire
-
stockage objet compatible S3 ou équivalent ;
-
système de fichiers contrôlé pour les prototypes ;
-
métadonnées obligatoires pour chaque document.
17.5 — Intelligence artificielle et traitement de données
-
Python ;
-
bibliothèques de traitement de données ;
-
services d’inférence documentés ;
-
modèles externes uniquement lorsque leur usage, leurs coûts et leurs conditions sont maîtrisés.
17.6 — Mobile
Pour les prototypes mobiles, Flutter est recommandé lorsque l’équipe dispose des compétences nécessaires. Une autre technologie peut être retenue si elle permet une intégration cohérente avec les API communes.
17.7 — Infrastructure
-
environnement Linux ;
-
conteneurisation Docker recommandée ;
-
fichiers de configuration reproductibles ;
-
séparation entre développement, test et démonstration ;
-
gestion sécurisée des variables d’environnement.
Article 18 — Justification des dérogations
Toute équipe utilisant une technologie différente de la stack recommandée doit fournir une justification courte indiquant :
-
le bénéfice attendu ;
-
les conséquences sur l’intégration ;
-
les dépendances supplémentaires ;
-
les besoins d’infrastructure ;
-
les risques éventuels ;
-
les modalités de maintenance.
TITRE V — STANDARDS DE DÉVELOPPEMENT
Article 19 — Langages et conventions
Chaque équipe doit adopter des conventions homogènes concernant :
-
le nommage des fichiers ;
-
le nommage des variables ;
-
le nommage des fonctions ;
-
les structures de dossiers ;
-
les commentaires ;
-
la gestion des erreurs ;
-
les réponses API ;
-
les messages de journalisation.
Article 20 — Qualité du code
Le code doit être :
-
lisible ;
-
structuré ;
-
commenté lorsque nécessaire ;
-
dépourvu de duplications inutiles ;
-
testable ;
-
organisé par responsabilité ;
-
exempt de secrets en dur ;
-
dépourvu de dépendances inutilisées.
Article 21 — Gestion des erreurs
Chaque service doit prévoir :
-
la validation des données entrantes ;
-
des codes d’erreur cohérents ;
-
des messages compréhensibles ;
-
la journalisation des erreurs importantes ;
-
la distinction entre erreur utilisateur, erreur métier et erreur système.
Article 22 — Configuration
Les paramètres de configuration ne doivent pas être directement codés dans les fichiers sources.
Ils doivent être gérés par :
-
variables d’environnement ;
-
fichiers de configuration non sensibles ;
-
secrets sécurisés ;
-
profils distincts selon l’environnement.
Article 23 — Tests
Chaque équipe doit prévoir au minimum :
-
des tests de fonctionnement des principales fonctions ;
-
des tests des routes API ;
-
des tests de validation des données ;
-
un scénario de démonstration ;
-
un test d’intégration avec au moins un autre composant lorsque cela est applicable.
TITRE VI — MODÈLE COMMUN DE DONNÉES
Article 24 — Principe général
Les données partagées entre les missions doivent reposer sur un modèle commun.
Une même entité ne doit pas être représentée de manière contradictoire dans plusieurs modules.
Article 25 — Entités principales
Le modèle commun doit prévoir, au minimum, les entités suivantes :
-
User ;
-
Profile ;
-
Role ;
-
Permission ;
-
Nation ;
-
Territory ;
-
Region ;
-
City ;
-
Institution ;
-
Organization ;
-
Company ;
-
Community ;
-
Publication ;
-
Comment ;
-
Reaction ;
-
Message ;
-
Event ;
-
Indicator ;
-
Dataset ;
-
Document ;
-
Notification ;
-
AuditLog.
Article 26 — Identifiants
Chaque entité doit disposer d’un identifiant unique.
Les équipes doivent éviter d’utiliser simultanément plusieurs identifiants concurrents pour une même entité.
Les identifiants peuvent être de type :
-
UUID ;
-
identifiant numérique ;
-
identifiant alphanumérique contrôlé.
Le choix doit être documenté et appliqué de manière uniforme.
Article 27 — Métadonnées communes
Les entités principales doivent prévoir, lorsque cela est pertinent :
-
id ;
-
created_at ;
-
updated_at ;
-
created_by ;
-
updated_by ;
-
status ;
-
visibility ;
-
version.
Article 28 — Statuts et visibilité
Les statuts doivent être définis par des valeurs contrôlées.
La visibilité des contenus peut notamment distinguer :
-
public ;
-
privé ;
-
réservé à une communauté ;
-
réservé à une institution ;
-
réservé à un groupe de travail ;
-
archivé ;
-
supprimé logiquement.
Article 29 — Données territoriales
Les données relatives aux Nations, territoires et localisations doivent utiliser des identifiants et formats compatibles.
Toute donnée géographique doit préciser, lorsque cela est nécessaire :
-
le nom ;
-
le type de territoire ;
-
le niveau administratif ;
-
le pays ou la Nation de rattachement ;
-
les coordonnées ;
-
le système de référence utilisé ;
-
la source ;
-
la date de mise à jour.
Article 30 — Données indiciaires
Tout indicateur doit être associé à :
-
un identifiant ;
-
un nom ;
-
une définition ;
-
une unité ;
-
une période ;
-
un territoire ou une entité concernée ;
-
une source ;
-
une méthode de calcul ;
-
un niveau de fiabilité ou de validation ;
-
une date de production.
Les indicateurs expérimentaux doivent être explicitement distingués des indicateurs validés.
Article 31 — Documents et sources
Tout document intégré au système doit être accompagné de métadonnées minimales :
-
titre ;
-
type ;
-
auteur ou organisme source ;
-
date ;
-
langue ;
-
niveau de confidentialité ;
-
origine ;
-
version ;
-
lien avec les entités concernées.
TITRE VII — API ET CONTRATS D’INTÉGRATION
Article 32 — Principe API-first
Toute fonctionnalité destinée à être utilisée par plusieurs composants doit être exposée par une interface documentée.
Les équipes ne doivent pas dépendre directement des tables internes d’une autre équipe sans accord explicite.
Article 33 — Style d’API recommandé
Les API doivent privilégier :
-
REST ;
-
JSON ;
-
routes clairement nommées ;
-
méthodes HTTP standards ;
-
réponses cohérentes ;
-
validation systématique ;
-
documentation OpenAPI ou équivalente.
Article 34 — Convention de routes
Les routes doivent suivre une convention homogène, par exemple :
/api/v1/users
/api/v1/profiles
/api/v1/nations
/api/v1/territories
/api/v1/institutions
/api/v1/publications
/api/v1/indicators
/api/v1/events
/api/v1/notifications
Article 35 — Versionnement
Les API doivent être versionnées.
La première édition utilise, sauf décision contraire :
/api/v1/
Toute modification incompatible doit entraîner :
-
une nouvelle version ;
-
une note de migration ;
-
une mise à jour de la documentation ;
-
une information des équipes concernées.
Article 36 — Format de réponse
Les réponses API doivent adopter une structure cohérente.
Exemple :
{
"success": true, "data": {}, "meta": {}, "error": null
}
En cas d’erreur :
{
"success": false, "data": null, "meta": {}, "error": { "code": "VALIDATION_ERROR",
"message": "Les données fournies sont invalides",
"details": []
}
}
Article 37 — Documentation des API
Chaque équipe doit fournir :
-
la liste des routes ;
-
les méthodes autorisées ;
-
les paramètres ;
-
les formats d’entrée ;
-
les formats de sortie ;
-
les codes d’erreur ;
-
les exigences d’authentification ;
-
des exemples d’utilisation.
Article 38 — Compatibilité entre missions
Les équipes doivent identifier les API nécessaires aux autres missions.
À titre indicatif :
|
Mission |
API principalement consommées |
|---|---|
|
Social Core |
Utilisateurs, profils, communautés, notifications |
|
Nation Digital Twin |
Nations, territoires, institutions, indicateurs |
|
Natiometric AI |
Données, documents, indicateurs, territoires |
|
Natioscope |
Indicateurs, territoires, événements, données |
|
Citizen |
Identité, profils, institutions, événements, consultations |
|
Data & Infrastructure |
Toutes les API et tous les services transversaux |
TITRE VIII — IDENTITÉ, AUTHENTIFICATION ET AUTORISATION
Article 39 — Identité commune
Les six missions doivent utiliser une logique commune d’identité.
Un utilisateur ne doit pas être obligé de créer six comptes distincts pour accéder aux six domaines fonctionnels.
Article 40 — Données minimales du compte
Le compte utilisateur peut comprendre :
-
identifiant ;
-
adresse électronique ou identifiant de connexion ;
-
nom d’affichage ;
-
statut ;
-
rôle ;
-
langue ;
-
date de création ;
-
état du compte.
Les données personnelles non nécessaires ne doivent pas être collectées.
Article 41 — Authentification
L’authentification doit être centralisée ou conçue de manière à pouvoir être centralisée ultérieurement.
Les mécanismes peuvent comprendre :
-
session sécurisée ;
-
jeton d’accès ;
-
renouvellement de jeton ;
-
authentification multifactorielle future ;
-
récupération contrôlée du compte.
Article 42 — Autorisation
L’autorisation doit distinguer :
-
l’identité de l’utilisateur ;
-
son rôle ;
-
ses permissions ;
-
son appartenance à une communauté ;
-
son lien avec une institution ;
-
son niveau d’accès aux données.
Article 43 — Rôles minimaux
À titre indicatif, les rôles suivants peuvent être prévus :
-
visiteur ;
-
utilisateur ;
-
contributeur ;
-
modérateur ;
-
chercheur ;
-
représentant institutionnel ;
-
administrateur ;
-
administrateur technique ;
-
super administrateur.
Article 44 — Sécurité des sessions
Les équipes doivent prévoir :
-
expiration des sessions ;
-
invalidation des jetons compromis ;
-
protection contre les accès non autorisés ;
-
limitation des tentatives ;
-
absence de secrets dans les journaux ;
-
protection des cookies ou jetons.
TITRE IX — ARCHITECTURE DES SIX MISSIONS
Article 45 — ORBIT 01 — SOCIAL CORE
Le Social Core constitue la couche sociale et relationnelle de SPACESORTIUM™.
Il doit pouvoir fournir :
-
profils ;
-
publications ;
-
commentaires ;
-
réactions ;
-
abonnements ;
-
communautés ;
-
groupes ;
-
notifications ;
-
messagerie ou système de contact minimal ;
-
fil d’actualité ;
-
recherche de personnes et de contenus.
Interfaces principales
Le Social Core doit pouvoir communiquer avec :
-
le service d’identité ;
-
le service Citizen ;
-
le service de notifications ;
-
le service de recherche ;
-
le service de communautés ;
-
les services institutionnels.
Exigence d’intégration
Les publications doivent pouvoir être associées, lorsque cela est pertinent, à :
-
une Nation ;
-
un territoire ;
-
une institution ;
-
un événement ;
-
une communauté ;
-
un indicateur ;
-
un document.
Article 46 — ORBIT 02 — NATION DIGITAL TWIN
Le Nation Digital Twin constitue la représentation numérique structurée d’une Nation, de ses territoires, de ses institutions et de ses principales composantes.
Il doit pouvoir gérer :
-
Nations ;
-
territoires ;
-
régions ;
-
villes ;
-
institutions ;
-
infrastructures ;
-
événements ;
-
indicateurs ;
-
relations entre entités ;
-
représentation cartographique ou schématique.
Interfaces principales
Le Nation Digital Twin doit fournir des données à :
-
Natiometric AI ;
-
Natioscope ;
-
Citizen ;
-
Social Core ;
-
Data & Infrastructure.
Exigence d’intégration
Les entités territoriales doivent disposer d’identifiants stables et réutilisables par les autres missions.
Article 47 — ORBIT 03 — NATIOMETRIC AI
La mission Natiometric AI constitue la première couche expérimentale d’intelligence artificielle appliquée aux données, aux indicateurs et aux problématiques natiométriques.
Elle peut comprendre :
-
ingestion de données ;
-
classification ;
-
extraction d’informations ;
-
analyse comparative ;
-
détection de tendances ;
-
génération de synthèses ;
-
interrogation conversationnelle ;
-
production de rapports ;
-
assistance à l’interprétation ;
-
préparation à l’intégration future des modules natiométriques spécialisés.
Interfaces principales
La Natiometric AI doit pouvoir accéder à :
-
des documents ;
-
des indicateurs ;
-
des données territoriales ;
-
des événements ;
-
des métadonnées ;
-
des référentiels validés.
Exigence d’intégration
Toute réponse produite par l’intelligence artificielle doit, lorsque cela est possible, être accompagnée :
-
de la source utilisée ;
-
de la date des données ;
-
du niveau de confiance ;
-
d’une indication claire lorsqu’il s’agit d’une estimation ou d’une interprétation expérimentale.
La première édition ne doit pas présenter une sortie expérimentale comme une vérité scientifique définitivement validée.
Article 48 — ORBIT 04 — NATIOSCOPE
Natioscope constitue la couche d’observation, de visualisation et d’exploration des données.
Il doit pouvoir présenter :
-
indicateurs ;
-
séries temporelles ;
-
comparaisons ;
-
cartes ;
-
tableaux ;
-
tendances ;
-
événements ;
-
alertes ou anomalies ;
-
vues par Nation ;
-
vues par territoire ;
-
vues par institution.
Interfaces principales
Natioscope doit consommer principalement :
-
les données du Nation Digital Twin ;
-
les indicateurs ;
-
les données produites ou enrichies par Natiometric AI ;
-
les événements ;
-
les métadonnées de source.
Exigence d’intégration
Les visualisations doivent distinguer :
-
données réelles ;
-
données simulées ;
-
données manquantes ;
-
données estimées ;
-
données expérimentales.
Article 49 — ORBIT 05 — CITIZEN
La mission Citizen constitue la couche de participation, d’interaction et de services destinés aux citoyens.
Elle peut comprendre :
-
profil citoyen ;
-
participation à des consultations ;
-
contributions ;
-
signalements ;
-
interaction avec les institutions ;
-
accès à des événements ;
-
suivi des demandes ;
-
consultation d’informations publiques ;
-
participation à des communautés territoriales.
Interfaces principales
Citizen doit pouvoir communiquer avec :
-
l’identité ;
-
le Social Core ;
-
le Nation Digital Twin ;
-
les institutions ;
-
les notifications ;
-
les événements.
Exigence d’intégration
Les fonctionnalités citoyennes doivent respecter une séparation claire entre :
-
information publique ;
-
contribution volontaire ;
-
donnée personnelle ;
-
donnée institutionnelle ;
-
donnée confidentielle.
Article 50 — ORBIT 06 — DATA & INFRASTRUCTURE
La mission Data & Infrastructure constitue le socle transversal de l’ensemble de l’opération.
Elle doit notamment traiter :
-
architecture des données ;
-
bases de données ;
-
API ;
-
authentification ;
-
déploiement ;
-
sécurité ;
-
sauvegarde ;
-
observabilité ;
-
journalisation ;
-
performance ;
-
documentation ;
-
intégration continue.
Interfaces principales
Cette mission doit fournir les outils et conventions nécessaires à toutes les autres équipes.
Exigence d’intégration
Aucune équipe ne doit être empêchée de démontrer son travail en raison de l’absence :
-
d’un environnement de test ;
-
d’une procédure de déploiement ;
-
d’une documentation API ;
-
d’un mécanisme d’authentification ;
-
d’un jeu de données de démonstration.
TITRE X — DONNÉES DE DÉMONSTRATION
Article 51 — Environnement de démonstration
Les équipes doivent travailler avec un jeu de données de démonstration commun.
Ce jeu de données peut comprendre :
-
quelques Nations ;
-
plusieurs territoires ;
-
des institutions fictives ou publiques ;
-
des utilisateurs de test ;
-
des publications ;
-
des indicateurs ;
-
des événements ;
-
des documents ;
-
des relations entre entités.
Article 52 — Données fictives et données réelles
Les données utilisées durant le hackathon doivent être clairement identifiées comme :
-
données fictives ;
-
données publiques ;
-
données synthétiques ;
-
données expérimentales ;
-
données réelles autorisées.
Aucune donnée personnelle sensible ne doit être introduite sans autorisation et sans dispositif approprié.
Article 53 — Cohérence du jeu de données
Les équipes doivent utiliser les mêmes identifiants de référence pour :
-
les Nations ;
-
les territoires ;
-
les institutions ;
-
les utilisateurs de test ;
-
les indicateurs ;
-
les événements.
TITRE XI — SÉCURITÉ, CONFIDENTIALITÉ ET PROTECTION DES DONNÉES
Article 54 — Principes minimaux
Les équipes doivent respecter les principes suivants :
-
minimisation des données ;
-
limitation des accès ;
-
traçabilité des opérations sensibles ;
-
protection des secrets ;
-
chiffrement lorsque nécessaire ;
-
séparation des environnements ;
-
sauvegarde ;
-
limitation des privilèges.
Article 55 — Secrets et identifiants techniques
Les mots de passe, clés API, jetons, certificats et autres secrets ne doivent jamais être publiés dans :
-
le dépôt Git ;
-
les captures d’écran ;
-
la documentation publique ;
-
les messages de discussion ;
-
les fichiers de démonstration.
Article 56 — Journalisation
Les journaux doivent permettre de comprendre :
-
les erreurs ;
-
les accès importants ;
-
les événements techniques ;
-
les opérations d’administration ;
-
les appels critiques.
Ils ne doivent pas exposer inutilement :
-
mots de passe ;
-
jetons ;
-
données personnelles ;
-
informations confidentielles ;
-
contenus privés.
Article 57 — Données produites par l’intelligence artificielle
Les résultats générés par l’IA doivent être traités comme des productions expérimentales tant qu’ils n’ont pas fait l’objet d’une validation appropriée.
Les interfaces doivent éviter de présenter automatiquement une réponse algorithmique comme une décision institutionnelle, scientifique ou juridique.
TITRE XII — INFRASTRUCTURE ET DÉPLOIEMENT
Article 58 — Environnements
Trois environnements sont recommandés :
-
Développement ;
-
Intégration ou test ;
-
Démonstration.
Lorsque les moyens le permettent, un environnement de préproduction peut être ajouté.
Article 59 — Déploiement reproductible
Chaque équipe doit fournir une procédure permettant de reproduire son environnement.
Cette procédure doit préciser :
-
les prérequis ;
-
les dépendances ;
-
les variables d’environnement ;
-
les commandes d’installation ;
-
les commandes de lancement ;
-
les commandes de test ;
-
les procédures de migration ;
-
les procédures d’arrêt.
Article 60 — Conteneurisation
La conteneurisation est recommandée pour les composants nécessitant plusieurs dépendances.
Lorsqu’elle est utilisée, l’équipe doit fournir :
-
un fichier Dockerfile ;
-
un fichier de configuration de lancement ;
-
les ports utilisés ;
-
les volumes nécessaires ;
-
les variables d’environnement ;
-
les instructions de démarrage.
Article 61 — Sauvegarde
Les données de démonstration et les configurations importantes doivent faire l’objet d’une sauvegarde.
La procédure de restauration doit être documentée lorsque cela est possible.
Article 62 — Supervision
L’infrastructure doit permettre de surveiller au minimum :
-
disponibilité des services ;
-
erreurs ;
-
consommation des ressources ;
-
état des bases de données ;
-
état des API ;
-
journaux critiques.
TITRE XIII — COLLABORATION, VERSIONNEMENT ET INTÉGRATION
Article 63 — Dépôt de code
Chaque équipe doit utiliser un dépôt de code identifié.
Le dépôt doit contenir :
-
le code source ;
-
la documentation ;
-
les fichiers de configuration non sensibles ;
-
les scripts de lancement ;
-
les tests ;
-
les exemples de données ;
-
l’historique des modifications.
Article 64 — Branches
Une organisation minimale peut comprendre :
-
main ou master : version stable ;
-
develop : intégration en cours ;
-
branches de fonctionnalités ;
-
branches de correction.
La convention définitive est arrêtée par le référent technique.
Article 65 — Commits
Les commits doivent être :
-
compréhensibles ;
-
suffisamment fréquents ;
-
liés à une fonctionnalité ou à une correction ;
-
dépourvus de fichiers inutiles ;
-
dépourvus de secrets.
Article 66 — Revue de code
Toute fonctionnalité importante doit, lorsque le temps le permet, faire l’objet d’une revue par au moins un autre membre de l’équipe.
Les éléments examinés portent notamment sur :
-
la lisibilité ;
-
la sécurité ;
-
les tests ;
-
la compatibilité ;
-
les dépendances ;
-
la documentation.
Article 67 — Intégration continue
Lorsque les moyens techniques le permettent, une procédure d’intégration continue doit vérifier :
-
l’installation ;
-
la compilation ;
-
les tests ;
-
le formatage ;
-
les erreurs critiques ;
-
la construction de l’application.
Article 68 — Registre des dépendances
Chaque équipe doit tenir à jour la liste des dépendances principales et signaler :
-
les bibliothèques critiques ;
-
les services externes ;
-
les licences particulières ;
-
les coûts éventuels ;
-
les risques de dépendance.
TITRE XIV — VALIDATION TECHNIQUE
Article 69 — Critères communs de validation
Un composant est considéré comme techniquement recevable lorsqu’il satisfait au minimum aux critères suivants :
-
Il peut être lancé dans un environnement identifié ;
-
Il dispose d’une documentation minimale ;
-
Il fonctionne sur un scénario de démonstration ;
-
Il respecte les interfaces communes ;
-
Il ne contient pas de secret exposé ;
-
Il dispose d’un mécanisme minimal de gestion des erreurs ;
-
Il peut être présenté à une autre équipe ;
-
Il possède un niveau minimal de testabilité ;
-
Ses limites sont clairement identifiées ;
-
Son intégration future est techniquement envisageable.
Article 70 — Niveaux de maturité
Les livrables peuvent être classés selon les niveaux suivants :
Niveau 0 — Concept
Idée, schéma ou description fonctionnelle sans implémentation.
Niveau 1 — Prototype
Fonctionnement partiel ou démonstration limitée.
Niveau 2 — Fonctionnalité opérationnelle
Fonctionnalité utilisable dans un environnement de test.
Niveau 3 — Composant intégrable
Fonctionnalité documentée, testée et connectable à d’autres composants.
Niveau 4 — Composant démontrable
Composant intégré dans un scénario global cohérent.
Niveau 5 — Composant préindustrialisable
Composant présentant des garanties renforcées de stabilité, sécurité, documentation et maintenance.
La première édition vise prioritairement les niveaux 2 à 4.
Article 71 — Tests d’intégration
Chaque équipe doit participer à au moins un test d’intégration avec une autre mission.
Les tests peuvent notamment porter sur :
-
la connexion d’un utilisateur ;
-
l’affichage d’une Nation ;
-
la récupération d’un indicateur ;
-
la publication d’un contenu lié à un territoire ;
-
l’affichage d’une donnée dans Natioscope ;
-
l’utilisation d’une donnée par Natiometric AI ;
-
l’envoi d’une notification ;
-
la soumission d’une contribution citoyenne.
TITRE XV — SCÉNARIO DE DÉMONSTRATION INTÉGRÉE
Article 72 — Finalité du scénario
Le scénario de démonstration intégrée doit montrer que les six missions ne constituent pas des prototypes indépendants, mais les premières composantes d’un même système.
Article 73 — Scénario recommandé
Le scénario peut suivre les étapes suivantes :
-
Un utilisateur crée ou utilise son compte ;
-
Il accède à son profil ;
-
Il sélectionne une Nation ou un territoire ;
-
Il consulte la fiche numérique de cette Nation ;
-
Il découvre des institutions, événements et indicateurs ;
-
Il publie une contribution liée à un territoire ;
-
Le contenu est visible dans le Social Core ;
-
Les données territoriales sont visualisées dans Natioscope ;
-
Natiometric AI produit une synthèse expérimentale à partir des données disponibles ;
-
L’utilisateur consulte une information ou participe à une interaction citoyenne ;
-
Les événements et notifications sont enregistrés ;
-
L’ensemble des opérations est observable dans l’environnement technique.
Article 74 — Résultat attendu
La démonstration doit permettre de visualiser la chaîne suivante :
IDENTITÉ ↓ PROFIL ↓ NATION / TERRITOIRE ↓ DONNÉES / INSTITUTIONS / INDICATEURS ↓ PUBLICATION / CONTRIBUTION ↓ NATIOMETRIC AI ↓ NATIOSCOPE ↓ CITIZEN ↓ NOTIFICATIONS / JOURNALISATION / INFRASTRUCTURE
TITRE XVI — LIVRABLES TECHNIQUES COMMUNS
Article 75 — Livrables obligatoires
Chaque équipe doit fournir :
-
le code source ;
-
un fichier README ;
-
une présentation de l’architecture ;
-
une description des fonctionnalités ;
-
la liste des dépendances ;
-
la procédure d’installation ;
-
la procédure de lancement ;
-
la procédure de test ;
-
la documentation des API ;
-
le modèle de données ;
-
les variables d’environnement nécessaires ;
-
un jeu de données de démonstration ;
-
les limites connues ;
-
les perspectives d’évolution.
Article 76 — Livrables d’intégration
Chaque équipe doit également fournir :
-
la liste des composants externes nécessaires ;
-
la liste des API consommées ;
-
la liste des API exposées ;
-
les événements produits ;
-
les événements consommés ;
-
les dépendances avec les autres missions ;
-
les points de blocage éventuels ;
-
les recommandations pour la suite.
Article 77 — Présentation technique
Lors de la démonstration, chaque équipe doit être capable d’expliquer :
-
Le problème traité ;
-
La solution développée ;
-
L’architecture retenue ;
-
Les choix technologiques ;
-
Le modèle de données ;
-
Les API ;
-
Les mécanismes de sécurité ;
-
Les interactions avec les autres missions ;
-
Les limites du prototype ;
-
Les conditions de passage à une version supérieure.
TITRE XVII — ÉVOLUTION VERS LES ÉDITIONS FUTURES
Article 78 — Préservation de l’architecture
L’architecture de la première édition doit permettre l’intégration progressive des modules spécialisés du Système International de Natiométrie.
Les équipes doivent donc éviter de créer des structures fermées qui empêcheraient l’ajout ultérieur de :
-
NATIOMÈTRE ;
-
NATIOTRON ;
-
NATIOVAULT ;
-
NATIOSPECTRE ;
-
NATIOCIVIS ;
-
NATIOTECH ;
-
autres modules de recherche, d’observation, de simulation ou d’intelligence.
Article 79 — Préparation de la deuxième édition
La deuxième édition pourra être consacrée à l’intégration plus approfondie des modules natiométriques.
Elle pourra notamment traiter :
-
les moteurs de calcul ;
-
les référentiels scientifiques ;
-
les systèmes de simulation ;
-
la mémoire et la traçabilité des données ;
-
les spectres et observations natiométriques ;
-
les interfaces scientifiques ;
-
les systèmes de validation ;
-
les mécanismes de gouvernance des données ;
-
les interactions entre intelligence artificielle et référentiels natiométriques.
Article 80 — Principe de compatibilité ascendante
Toute évolution future devra, autant que possible :
-
préserver les identifiants existants ;
-
documenter les migrations ;
-
maintenir les API importantes ;
-
éviter les ruptures non justifiées ;
-
préserver les données ;
-
assurer la continuité des services.
TITRE XVIII — DISPOSITIONS FINALES
Article 81 — Autorité technique
Le comité technique de l’opération est chargé :
-
d’interpréter le présent document ;
-
d’arbitrer les choix technologiques ;
-
de valider les dérogations ;
-
de coordonner les interfaces ;
-
de résoudre les conflits d’architecture ;
-
de définir les standards complémentaires ;
-
de superviser les tests d’intégration.
Article 82 — Adaptation pendant l’événement
Le présent document constitue une architecture de référence et non une contrainte immuable.
Des adaptations peuvent être décidées lorsque :
-
elles améliorent l’intégration ;
-
elles réduisent un risque ;
-
elles facilitent la démonstration ;
-
elles sont documentées ;
-
elles ne compromettent pas la cohérence globale.
Article 83 — Priorité à l’intégration
En cas de conflit entre une fonctionnalité isolée et la cohérence globale du système, la priorité doit être accordée à la solution permettant la meilleure intégration.
Article 84 — Formule directrice
La réussite technique de la première édition repose sur la chaîne suivante :
CONCEVOIR ENSEMBLE → DÉVELOPPER PAR MODULES → PARTAGER LES STANDARDS → INTÉGRER LES COMPOSANTS → TESTER LE SYSTÈME → PRÉPARER L’INDUSTRIALISATION
Conclusion
Le SPACESORTIUM ORBIT HACKATHON™ doit produire davantage qu’une collection de démonstrateurs.
Il doit établir les premières fondations d’une infrastructure numérique capable de relier :
-
les utilisateurs ;
-
les Nations ;
-
les territoires ;
-
les institutions ;
-
les données ;
-
les intelligences ;
-
les services ;
-
les systèmes d’observation ;
-
les futures technologies natiométriques.
Les six équipes peuvent travailler sur des missions différentes. Elles doivent néanmoins partager une même vision architecturale.
Leur objectif commun n’est pas seulement de coder des fonctionnalités.
Il est de construire les premières composantes d’un système cohérent, évolutif et intégrable dans SPACESORTIUM™.
BUILD THE COMPONENTS.
CONNECT THE SYSTEM.
INTEGRATE THE FUTURE.
PUT SPACESORTIUM™ INTO ORBIT.
Ce document pourra ensuite être suivi par un document de spécifications détaillées des API et du modèle de données commun, qui constituera la version plus opérationnelle destinée directement aux équipes de développement.